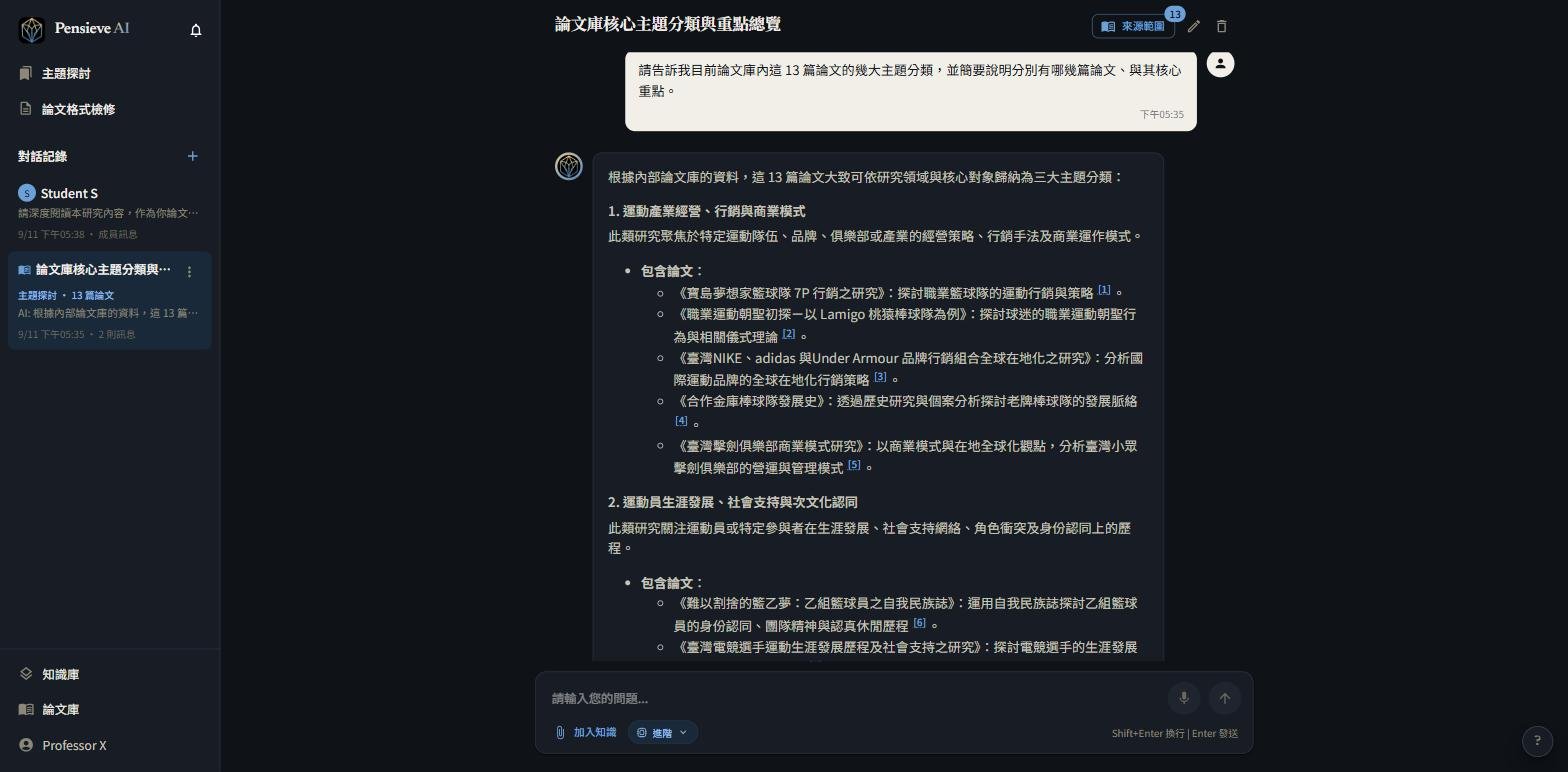
每年九月,一切重來一次
重複本身不只是浪費時間,它會磨損一個人教學的熱情。而且不論你帶 4 個學生還是 15 個,結構都一樣——每一個人卡住的時候,能問的只有你。你的時間被切成碎片,剩下能做自己研究的,所剩無幾。
從入庫,到一份你願意看的初稿
有些研究團隊會讓博士生先幫碩士生看過第一輪。Pensieve AI 補上的就是那一層——讓每個學生都有,也讓學長姐不必被反覆佔用。
- 系統
第一天就不是空白
新生打開的不是空資料庫。導入時我們會協助把團隊既有的文獻建進來,之後每一屆的累積也都留在裡面;而且每一份都用你設定的視角解析過,外文文獻附中文解析。
初始建庫服務依方案包含 100–400 篇文獻,由我們代為建置,超出部分可另行安排。
- 學生
卡住的時候有地方問
讀不懂就直接問。答案附上引用段落、追得回原文,也看得到學長姐與你當年在那一段旁邊留下的討論。
- 學生
自己把初稿推到能看
跨文獻做主題總覽與方法比較,整理研究背景;APA 內文引用即時檢修,參考文獻直接從書庫產生。
- 你
你只需要出場一次
學生帶著已經有結構、有引用、有出處的初稿來找你。你談的是論點與研究設計,不是格式與基礎文獻。
前三步不需要你在場。省下來的時間,是你做自己研究、寫計畫書、或單純喘口氣的時間。
你讀論文的方式,
可以留給每一屆學生
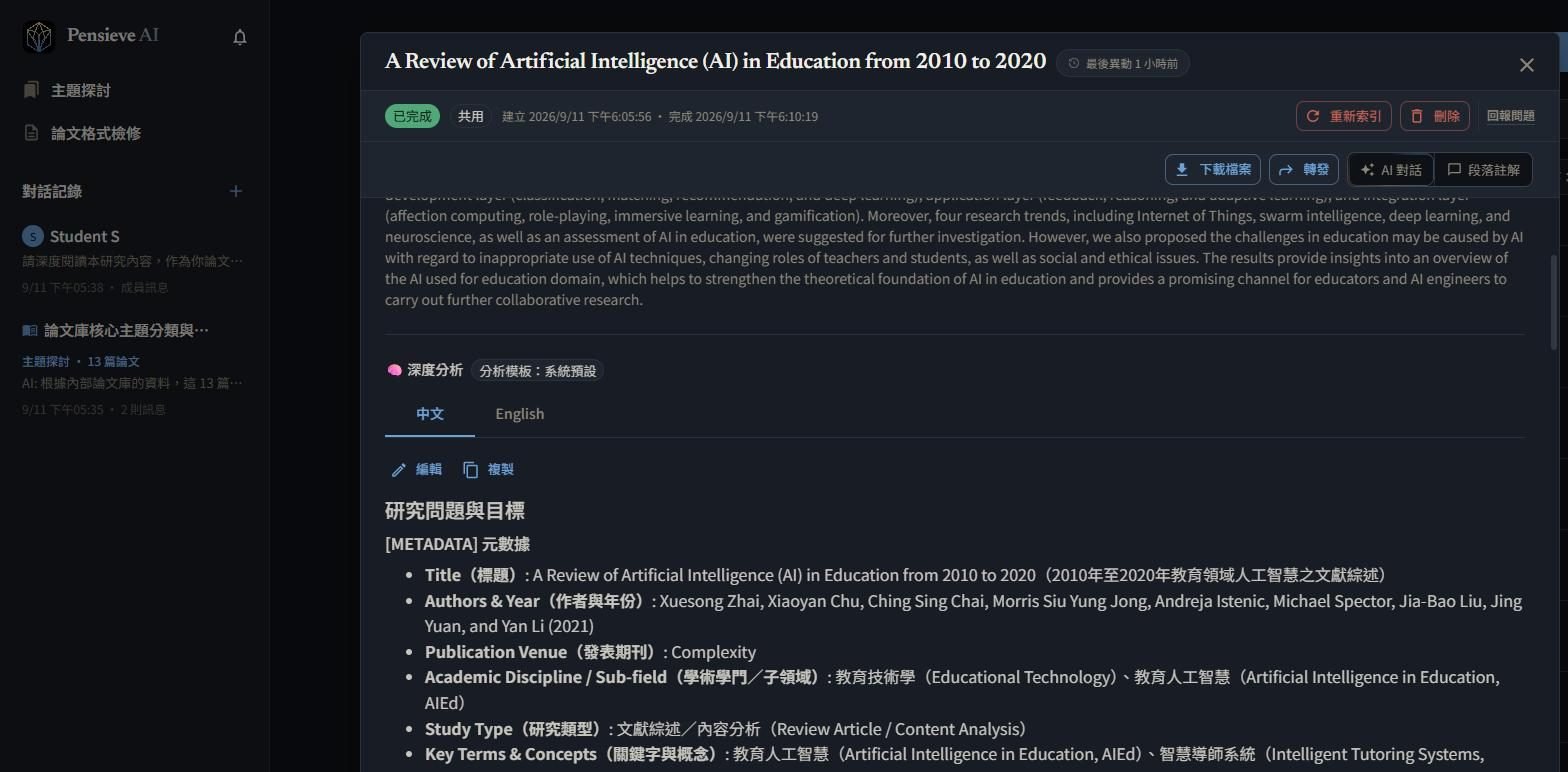
把「怎麼讀」寫下來一次,之後每一份都照著讀。你設定的學術角色、分析框架與章節結構,會自動套用在團隊書庫的每一份文獻上——學生讀到的解析,是用你的眼光讀出來的。
你定義視角
在組織管理裡設定預設解析模板。以運動社會學團隊為例,模板指定了兩個閱讀角色與一套結構化框架。
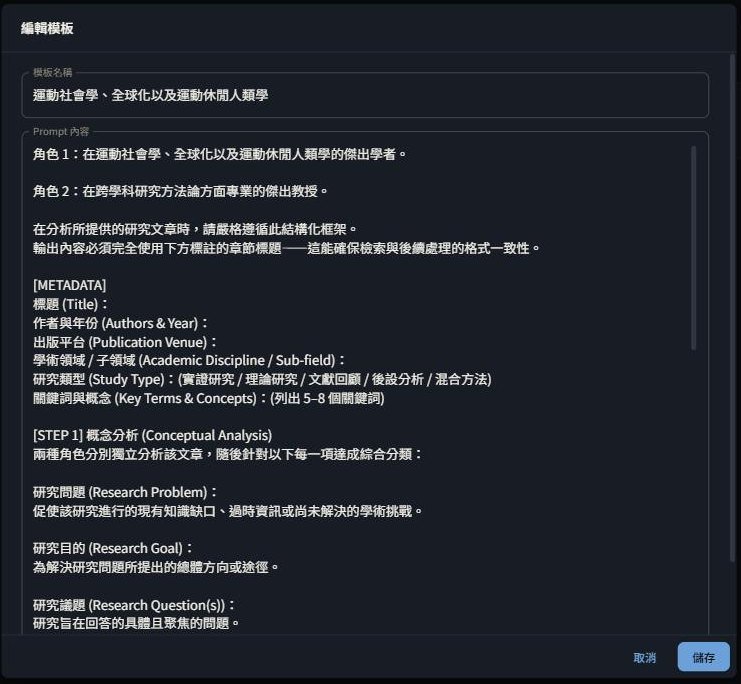
每一份都照這個視角讀
同一份文獻進到書庫後,產出的是依此框架寫成的結構化解析——研究問題與目標、綜合分類、理論框架,而且是從你指定的兩個角色視角讀出來的。
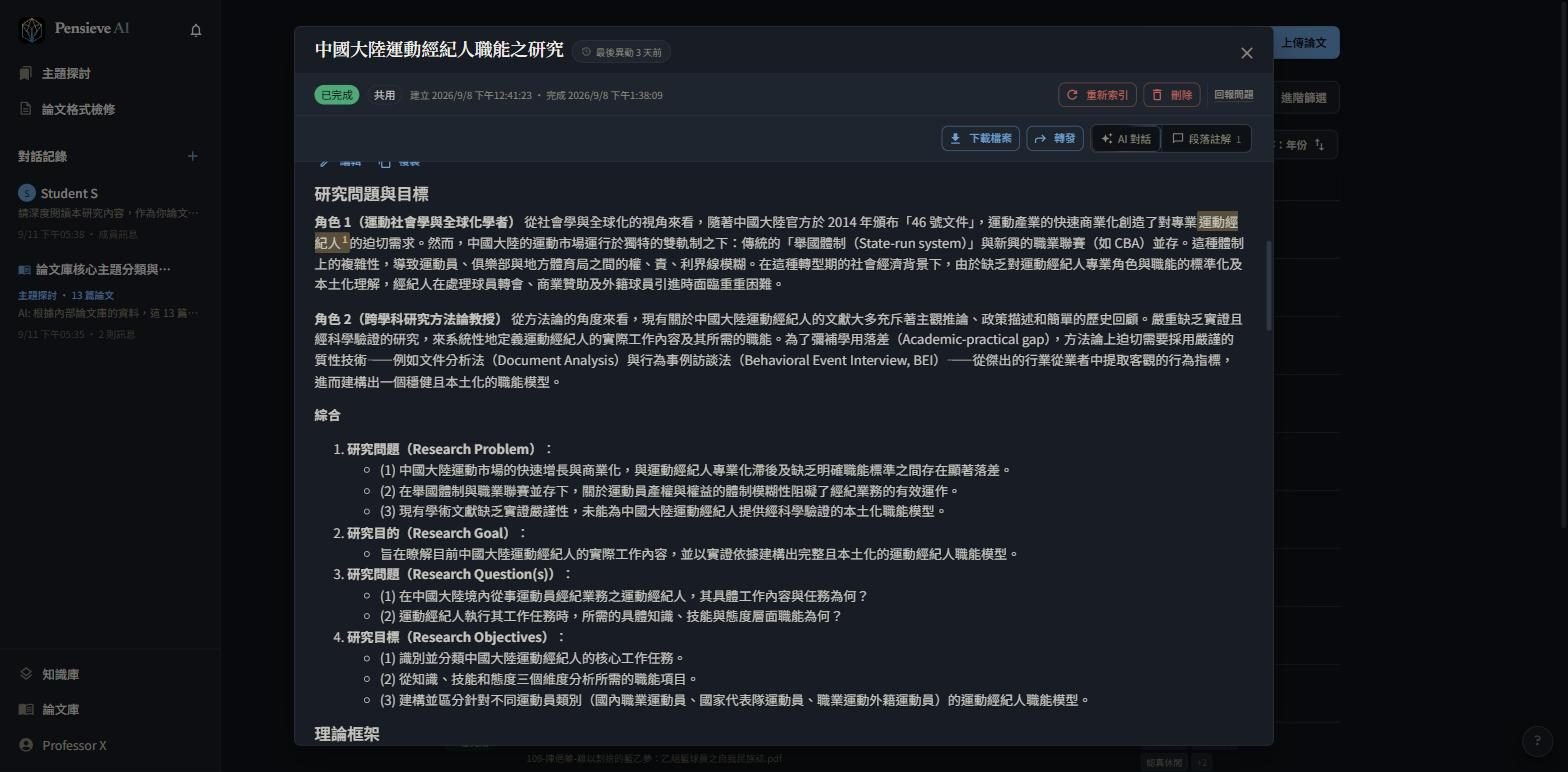
成員看得到解析,看不到 prompt 內容。模板只對成員顯示名稱。你的視角傳了下去,你的方法論沒有外流——學生畢業時也帶不走。
不同情境需要不同角度?可以建立多份模板
- 組織設有一份預設模板,成員索引文獻時未自選模板即自動套用。
- 管理者可另外建立多份情境模板,成員上傳時自行選用——同一份文獻,做文獻回顧與做方法比較需要的解析角度並不相同。
- 模板僅限組織管理者(指導教授或助教)編輯,一般成員只看得到名稱。
一個帳號,兩個空間
共用的是底盤,私密的是你自己的思考過程。團隊累積的文獻人人可用,但你的題目、你的筆記、你跟 AI 的每一次對話,只有你看得到。
整個研究團隊的共同底盤
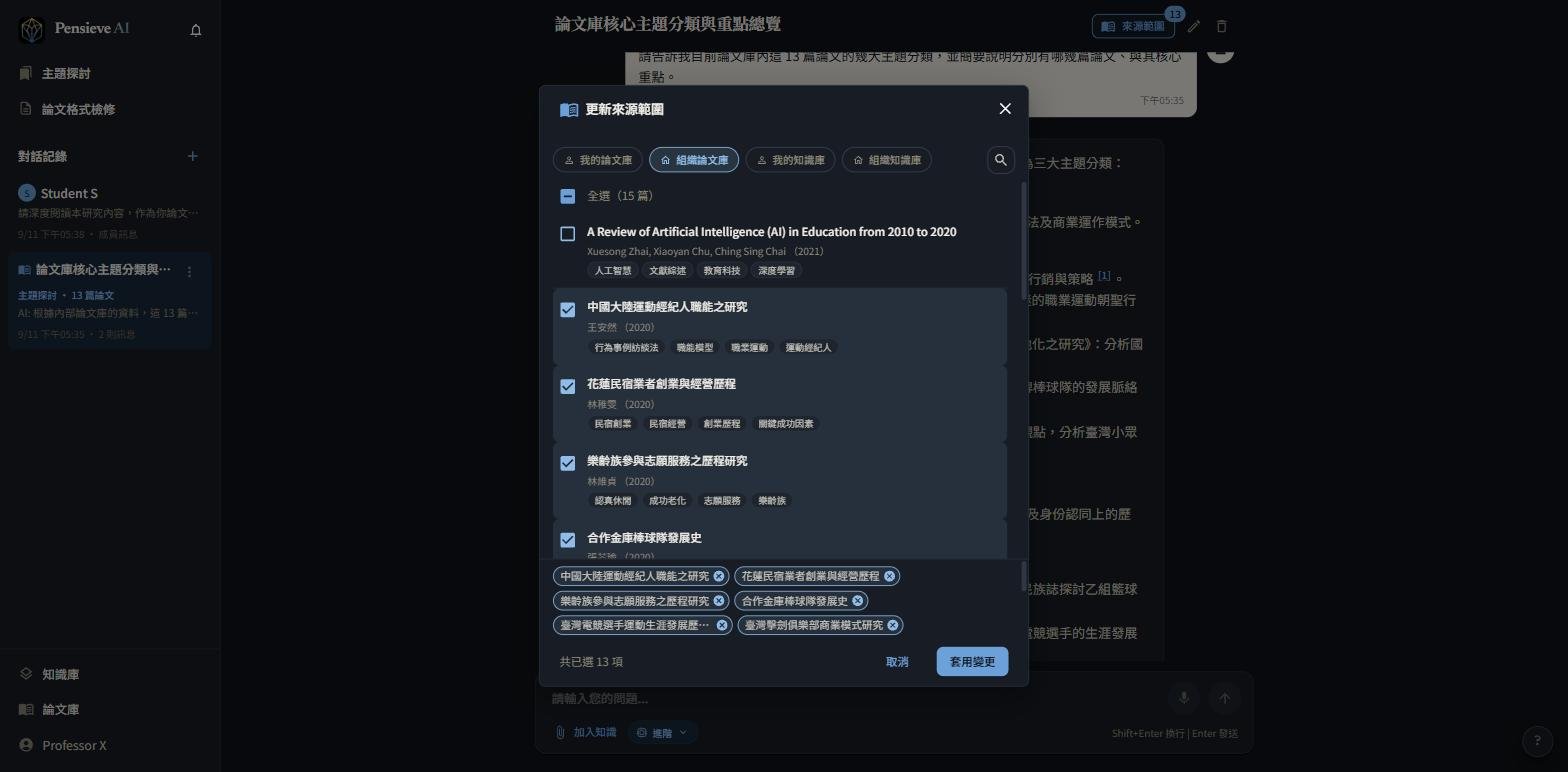
- 團隊論文庫——歷屆成員上傳的文獻集中一處,每一份都經過深度解析。
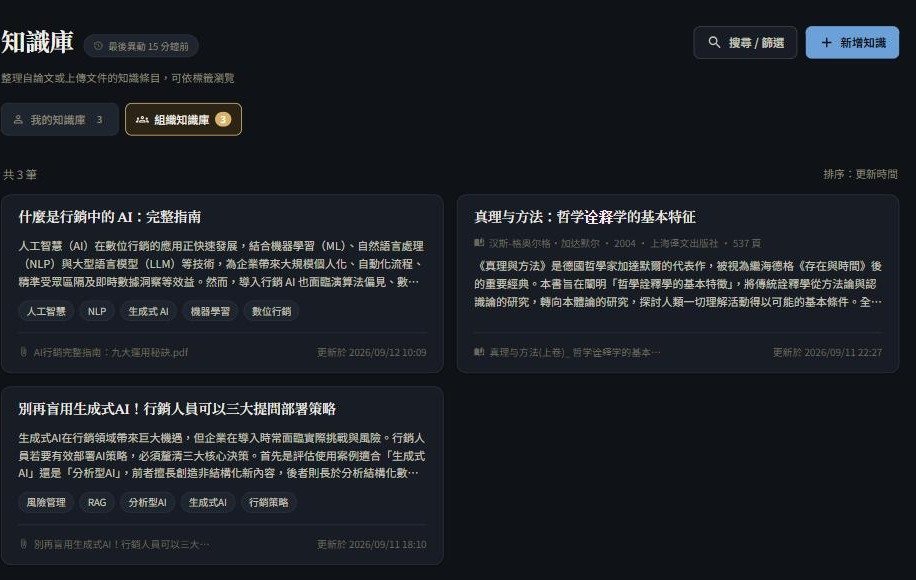
- 團隊資料庫不只收論文——專書、新聞媒體報導、田野筆記、講義與手冊都能存入,成為可檢索、可對話的知識條目。
- 上百頁的電子書也進得來——大部頭的掃描書籍支援整本匯入,長篇文件採分段處理,不必先自己切成好幾份。
- 註解與討論留在文獻上——段落註解、討論串、@mention,不散落在各自的聊天視窗。
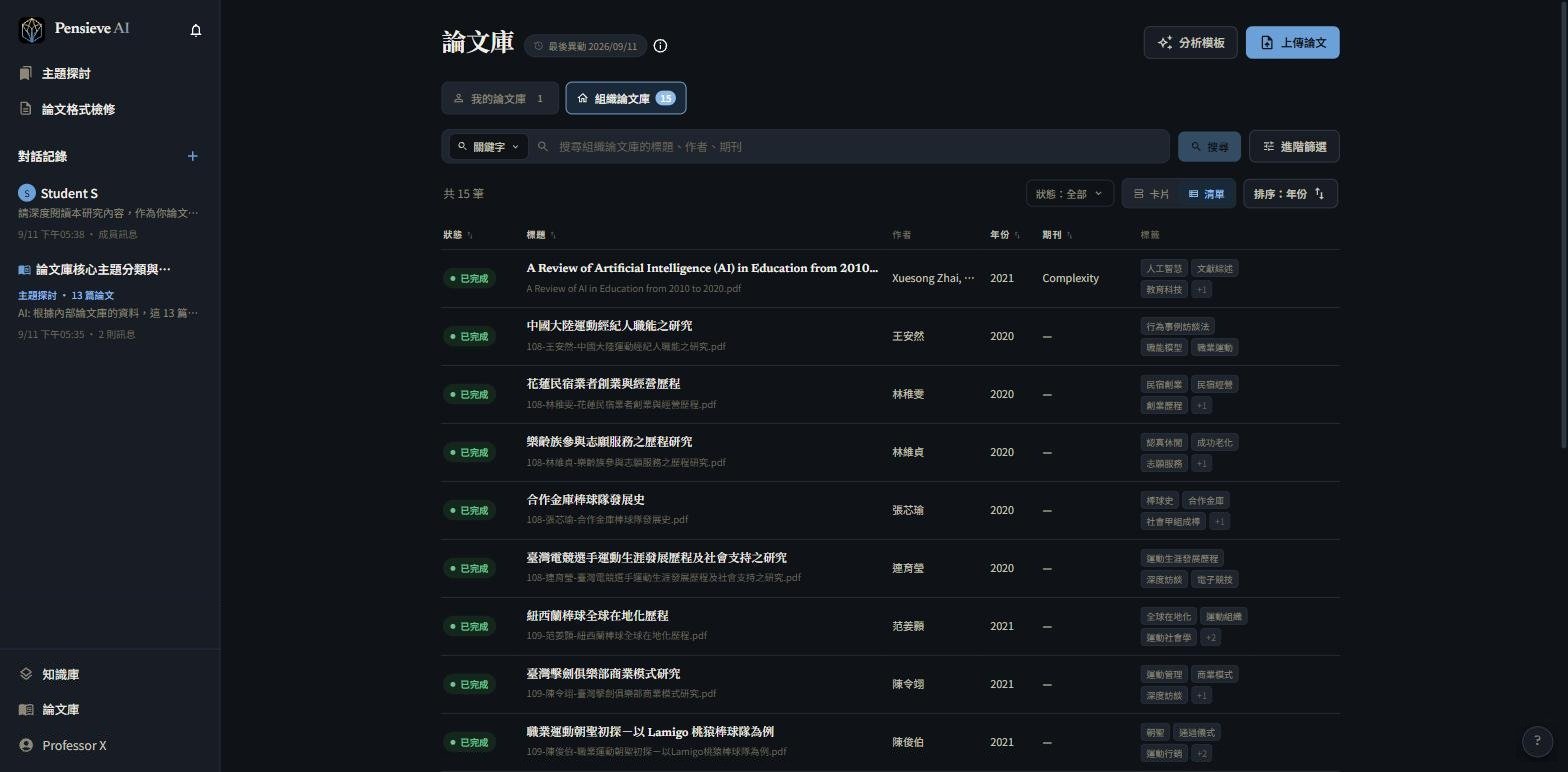
只有你看得到的那一半
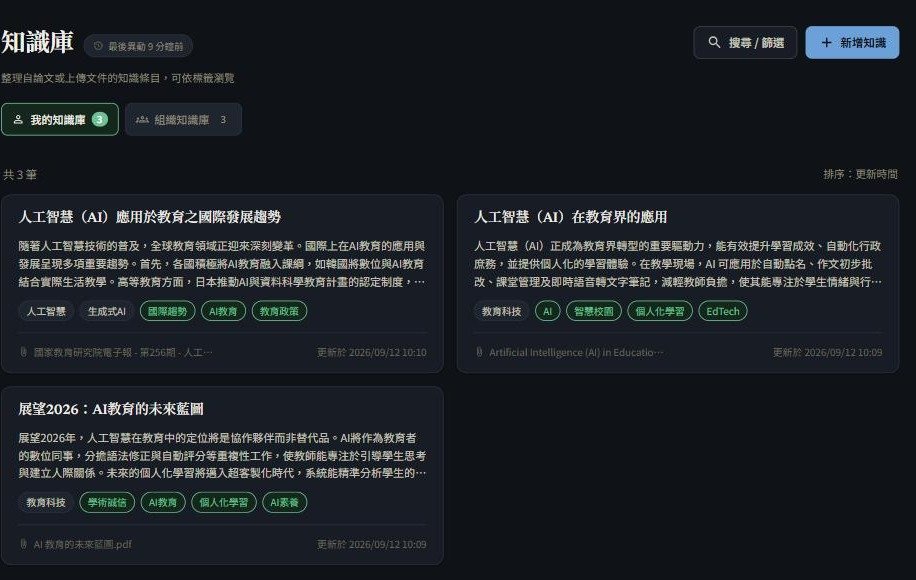
- 我的論文庫與知識庫——你自己題目的文獻、專門素材、非論文資料與個人筆記,都放在只有你看得到的地方,獨立於團隊之外。
- 私密的 AI 對話——你跟 AI 的每一次討論都留在自己的空間,指導者與同儕都看不到。
- 想分享時才分享——一則筆記、一段 AI 回答,你決定要不要轉進團隊。
- 對話範圍你自己選——每次提問時,指定要讓 AI 讀團隊論文庫、組織知識庫,還是只讀你自己的資料。
從讀懂一份文獻,
到寫出一篇論文
學術文獻是出了名的難解:雙欄排版、掃描檔、跨頁表格、實驗圖表。通用工具在這裡失真,答案就從源頭錯了。
展開詳細說明
- 讀得出結構,不只抽得出文字——雙欄期刊、掃描檔、跨頁表格與圖表都拆得開。
- 整本專書都能進來——支援整本專書匯入,長篇文件採分段處理。
- 書目欄位自動帶出——標題、作者、年份、DOI、期刊卷期頁一次到位,重複上傳會自動偵測。
- 外文自動附中文解析——學生不必先跨過語言那道門檻。
關鍵字搜尋只能告訴你「哪幾份提過」。研究者要的是「這些文獻在這件事上說了什麼、有沒有互相矛盾」——而且每一句都要查得到出處。
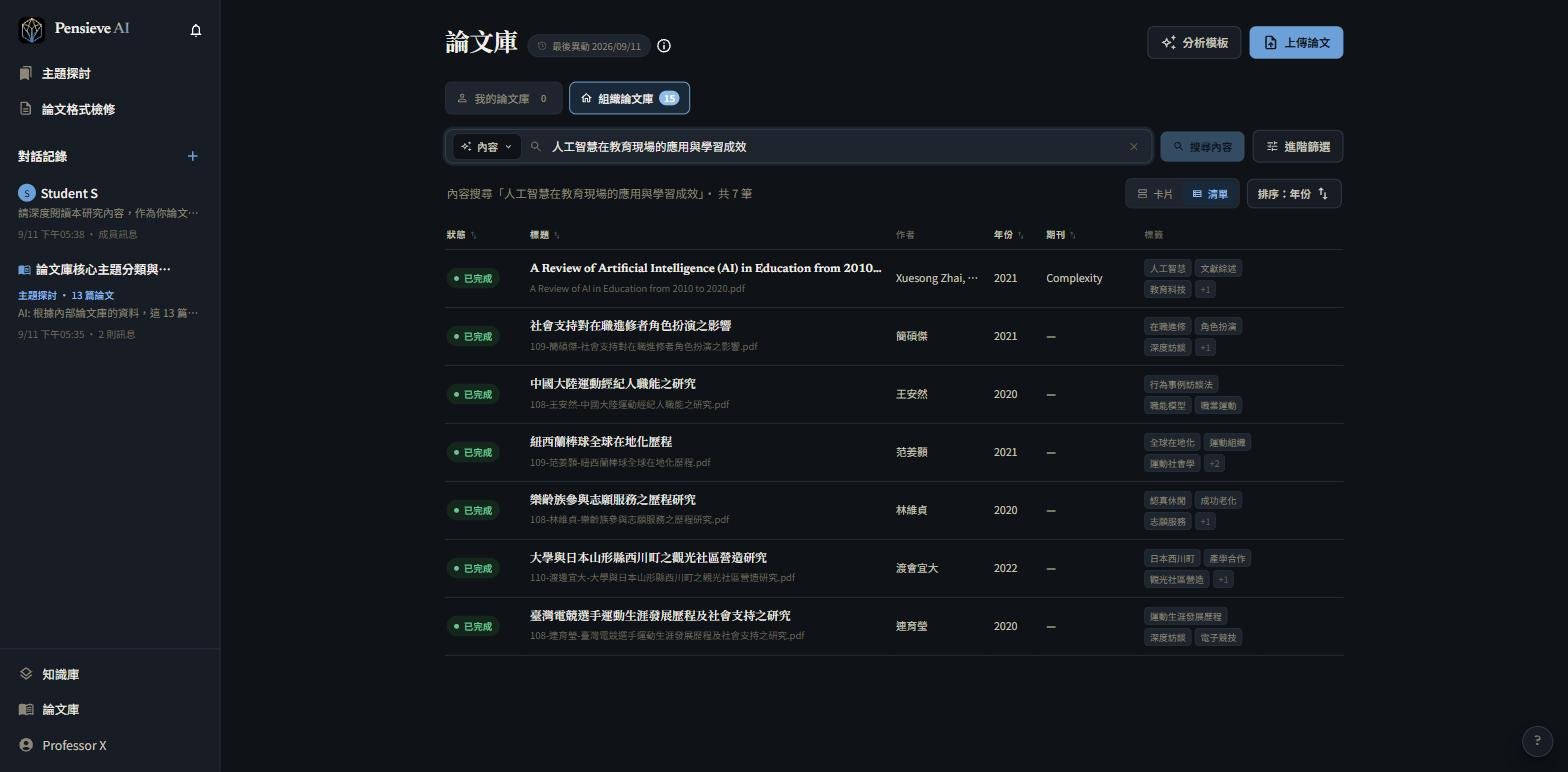
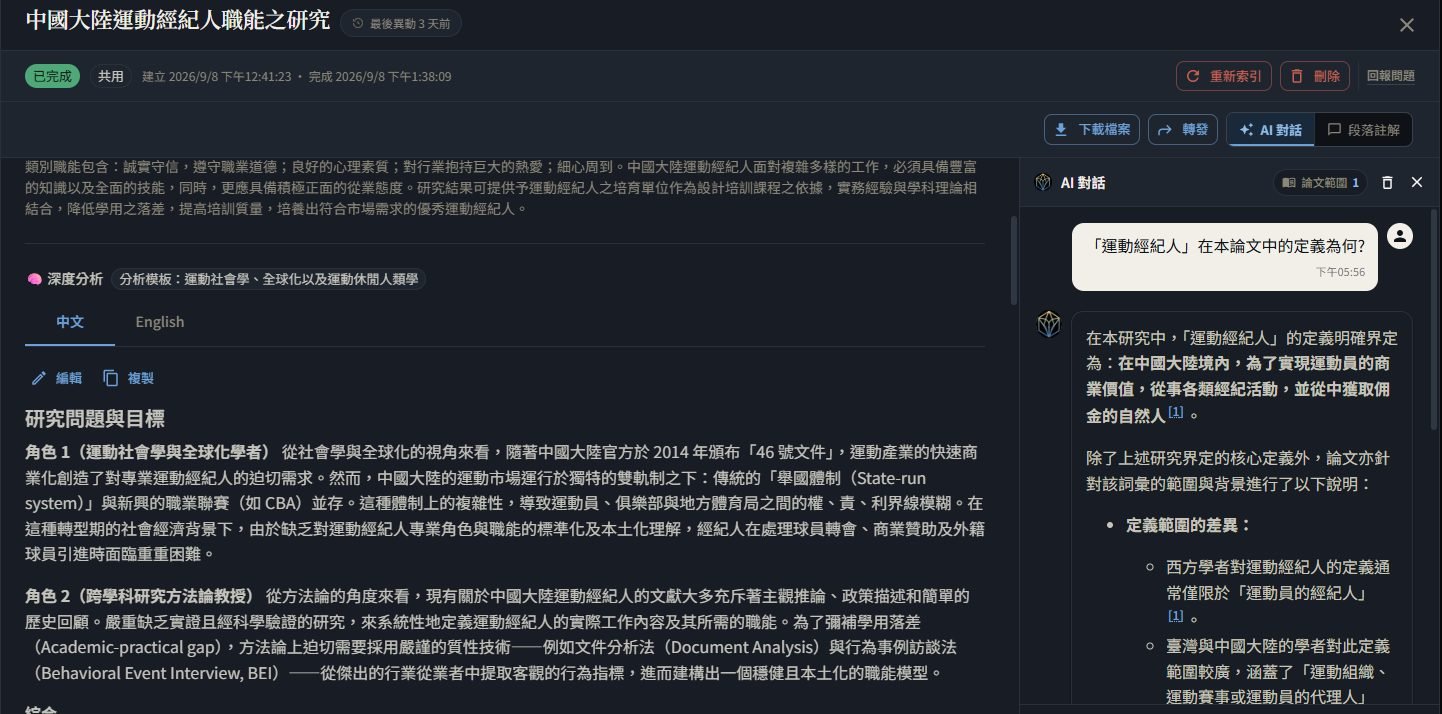
來源卡會標明這段是取自 PDF 原文,還是取自 AI 解析。
展開詳細說明
- 答得出來就附出處——每一句都指得出落在哪一份文獻、哪一段。
- 答不出來會直說——手邊資料不足以回答時會告訴你找不到,不會用沾邊的段落湊一個答案。
- 跨文獻分析——依學術領域產出主題總覽,或針對研究方法做結構化比較。
- 語意提問可加條件——年份、作者、期刊、標籤都能與語意查詢並用。
書庫不只是拿來讀的。團隊裡的每個人——教授、博士後、碩博士生——都在這裡推進自己的寫作。
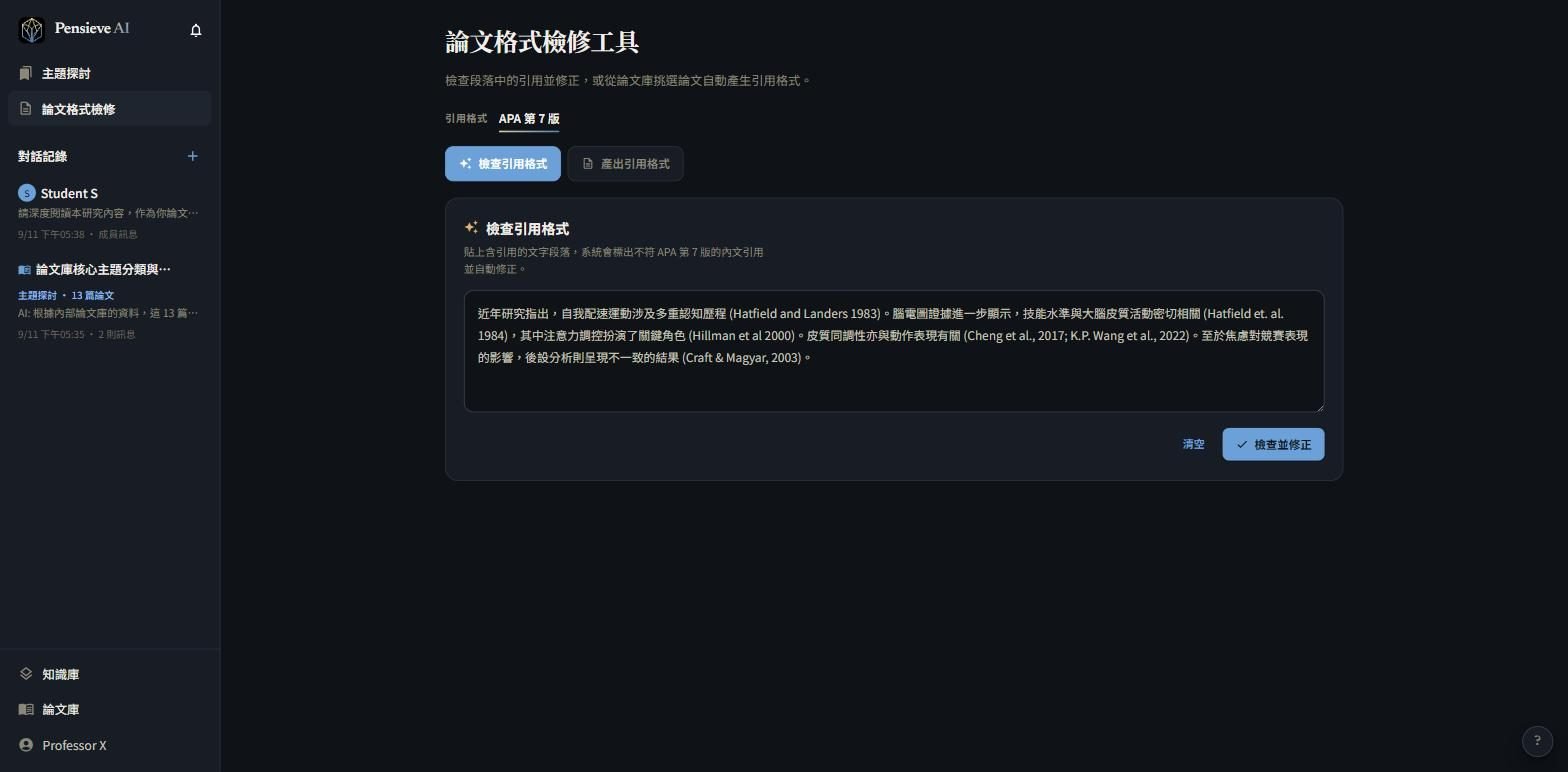
展開詳細說明
- APA 第 7 版引用檢修——內文引用格式檢查與自動修正,複雜的作者姓名寫法也認得。
- 參考文獻產生——直接從書庫挑選文獻產出參考文獻清單。
- 語音輸入——想到哪講到哪,不必先把句子想完整;錄音轉文字送進對話,標點依語系自動正規化。
- 解析可編輯——深度解析的內容你可以直接改,加上自己的判斷。
研究團隊裡最有價值的對話,往往發生在某一份文獻的某一段旁邊。那些討論不該散落在各自的聊天視窗。
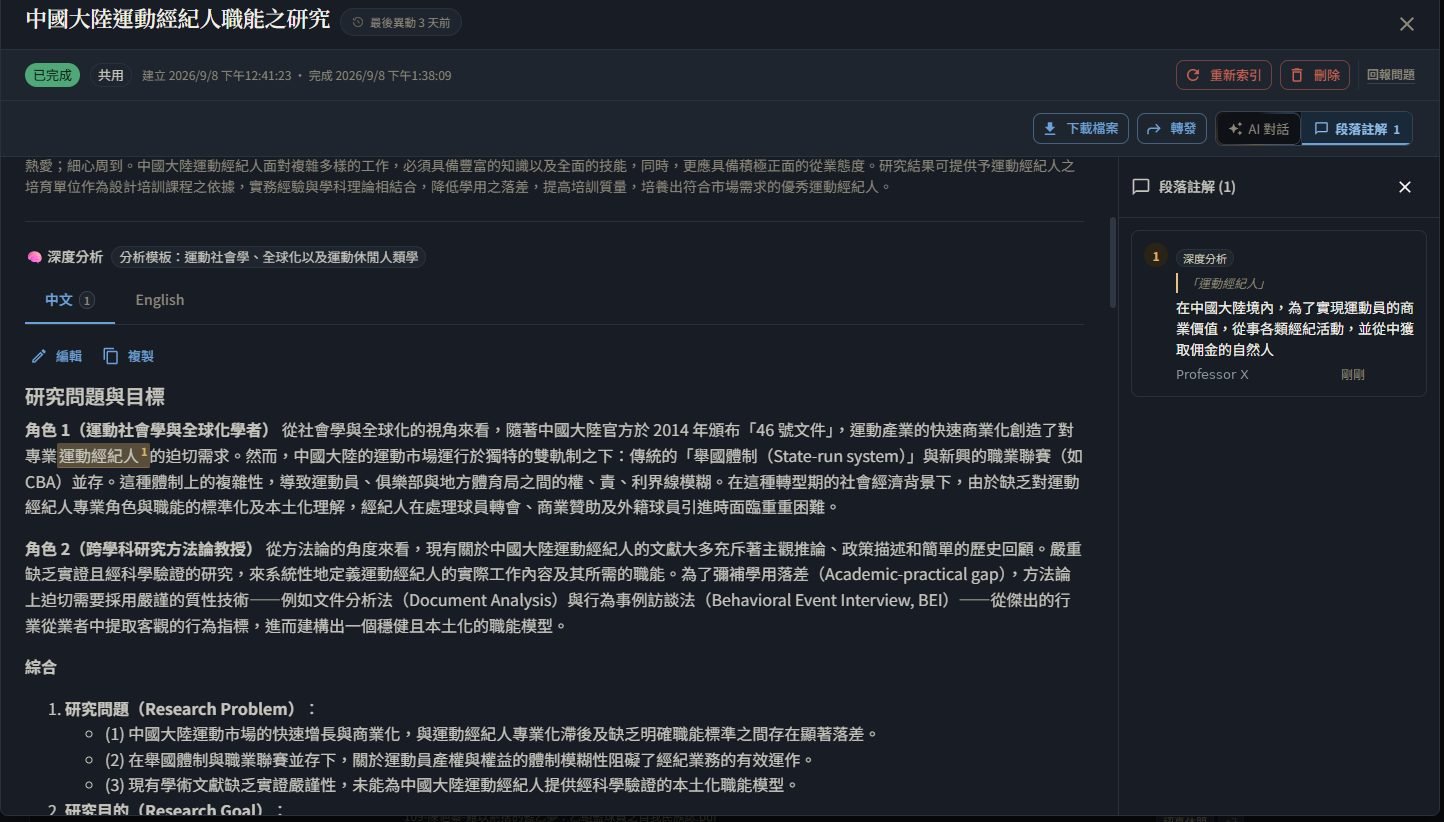
展開詳細說明
- 段落註解與回覆——選取摘要或解析的任一段落直接留言,形成討論串。
- 指導者認可的註解會被優先參考——置頂的評論會成為之後 AI 作答的依據之一。
- 分享卡片——文獻、知識條目或一段 AI 回答,一鍵轉寄給團隊成員。
- @mention 與通知中心——在註解與對話中提及成員,即時提醒。
免費的通用 AI 也能讀論文,
為什麼還要另外付費?
能,而且很多研究者現在就是這樣做的。差別不在單次提問的品質,而在這件事重複一百次、跨越好幾屆學生之後,兩邊留下了什麼。
搜尋工具 + 通用型 AI + 筆記工具
- 在資料庫搜到文獻,一篇一篇下載 PDF
- 上傳到通用型 AI 或筆記工具,一次一批
- 複製段落、貼上、提問;換一篇再貼一次
- 要自己翻回 PDF 找到那一段,才知道該引哪一頁
- 引用格式自己整理,參考文獻自己排
- 讀完的心得留在自己的對話紀錄與筆記軟體裡
- 學生畢業,這些全部跟著帳號走。下一屆進來,整套重做一次
一座團隊共用的書庫
- 拖進來,或從 Zotero 一鍵匯入既有書庫
- 每一份自動解析,而且是用你設定的視角讀的;外文附中文
- 直接對整座書庫提問,不必複製貼上
- 答案附段落出處,點開就看到落在哪一章、哪一段
- 引用即時檢修,參考文獻直接從書庫產生
- 註解與討論留在文獻上,成為團隊資產
- 下一屆進來,這些都已經在裡面
省下的不是一次搜尋的時間,是每一屆重來一次的時間。通用型 AI 幫的是「這一次提問」;Pensieve AI 幫的是「這個研究團隊的十年」。
對某些學科來說,
一本專書的份量重於十篇論文
文獻工具幾乎都是照著理工科的引文生態設計的。但在人文與社會科學,理論的根扎在專書、經典文本與長篇論述裡。Pensieve AI 的書庫不挑食——進來之後一視同仁地可檢索、可對話、可註解。
- 期刊論文
- 學術專書
- 掃描電子書
- 新聞媒體報導
- 田野筆記
- 講義與手冊
- 個人筆記
看得到用量,才控得住預算
機構採購最怕的不是貴,是買了沒人用。管理者可以直接看到每位成員的使用狀況——團隊有沒有真的在用、用得多深,不必用猜的。
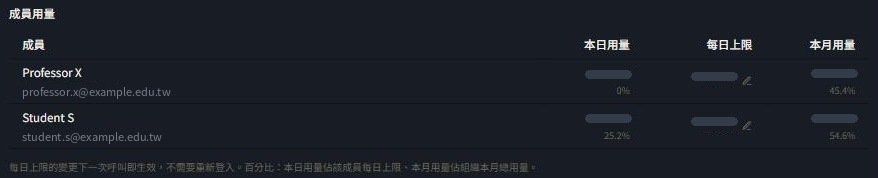
用量看得見,也管得住
每位成員的使用量都在後台,管理者也可以替每位成員個別設定每日用量上限。哪些人在深度使用、哪些人還沒上手,一眼就分得出來;預算也不會被單一成員的密集使用一次用光。
導入不必從零開始
團隊既有的文獻由我們協助建進系統並完成解析,成員第一次登入就有東西可用,不必先花幾週自己上傳。
資料是真的分開存放
不同組織與個人的資料在儲存層就各自獨立,不是同一份資料靠權限設定去擋。跨組織之間無從互相檢索。
不必重建你的書庫
Zotero 一鍵匯入既有書庫,可沿用原有書目資料;成員以 Google 帳號登入,由管理者發送邀請,不必另外管一組密碼。
用量數據是為了讓管理者知道預算花在哪、團隊用得夠不夠深,據以調整資源——它的用途是管理團隊的投入與成本,不是拿來盯人。成員的個人空間與私密對話不在其中。
採購前你會想問的事
學生用 AI 讀文獻,會有學術誠信的問題嗎?
Pensieve AI 的定位是輔助而不取代。系統產出的是文獻解析與帶出處的檢索結果,不是替使用者撰寫論文內容;每一段回答都可追回原始段落,供使用者自行查證與判斷。使用時應依所屬機構的 AI 使用揭露規範說明工具使用情形。
指導教授看得到學生的個人資料與對話嗎?
看不到。成員存放在個人空間的資料、筆記與 AI 對話僅該成員本人可見。管理者能看到的是團隊共用範圍的內容,以及成員的使用量統計(用於掌握團隊的投入狀況),不包含對話內容本身。
我們的文獻與研究資料安全嗎?
不同組織與個人的資料在儲存層就各自獨立,不是同一份資料靠權限設定去過濾,跨組織之間無法互相檢索。原始檔案存放於雲端,存取權限依組織成員身分控管。更完整的資安說明可於導覽時提供。
支援哪些檔案格式?
論文與一般文件支援 PDF;知識庫條目另外支援 Word(.docx)、純文字與 Markdown。掃描檔與雙欄排版的期刊論文皆在支援範圍內;數百頁的掃描專書支援整本匯入,長篇文件採分段處理。
學生畢業之後,他上傳的文獻和註解還在嗎?
存放在組織範圍的文獻、知識條目與註解屬於團隊資產,不隨個別成員異動而消失;成員存放在個人範圍的內容不屬於團隊資產,其他成員與管理者都看不到。組織管理者可調整成員身分與存取權限。
可以沿用我們現有的 Zotero 書庫嗎?
可以。以 OAuth 或 API Key 連接後選擇要匯入的 library 與 collection,並可選擇沿用 Zotero 中既有的書目資料以跳過重複的中繼資料抽取,降低匯入成本。
從一個研究團隊開始
我們目前以研究團隊為單位合作。導覽時會用你自己團隊的幾份文獻實際跑一次解析與提問,再依團隊規模與需求討論合作方式。
研究團隊
適合:帶領研究團隊的指導教授與其學生
- 團隊共用文獻庫與知識庫
- 每位成員各自的論文庫與知識庫
- 自訂解析模板(預設模板+多情境模板)
- 段落註解、討論串與分享卡片
- @mention 與通知中心
- 成員用量儀表板與每日上限設定
- 角色權限與邀請管理
- 初始文獻庫由我們代為建置(依方案包含 100–400 篇)
方案內容與價格將於正式上線前公告。現階段歡迎先預約導覽,我們會依你的團隊規模與需求說明合作方式。
這學期,我們想找幾個
願意一起把它用起來的研究團隊
我們正在尋找不同學科的研究團隊,一起把 Pensieve AI 用進真實的研究流程裡。早期夥伴的意見會直接影響產品接下來的走向——你在訪談裡提出的問題,我們會拿回去改。
- 對象
- 以研究團隊為單位,個人使用者暫不適用
- 名額
- 限量開放
- 你會得到
- 完整的產品體驗,以及比一般試用更高的免費使用額度
- 我們希望得到
- 至少兩次使用訪談,線上或線下都可以
表單中可選擇『申請試用』或『加入早期夥伴計畫』。
留下聯絡方式,我們跟你約時間
導覽大約三十分鐘,線上進行。我們會用你自己團隊的幾份文獻實際跑一次解析與提問。